

IBM、AMD与橡树岭实验室联手:让量子计算机和超算“住进同一个机房”
美国纽约州波基普西——美国能源部资助的橡树岭国家实验室(ORNL) 旗下量子科学中心(QSC),联合IBM与AMD,于11月5日发布了一个全新的量子纠错(QEC)协同设计平台。该平台首次将IBM的量子处理器与ORNL的高性能计算(HPC)系统部署在同一物理地点,以低延迟方式协同工作。
平台构成:120量子比特处理器 + AMD加速的HPC集群
首批部署位于IBM波基普西基地。量子侧为IBM 120量子比特的Quantum Nighthawk处理器;经典侧为ORNL的Umbra高性能计算系统,搭载AMD Instinct MI355X GPU与第五代AMD EPYC CPU。Nighthawk拥有方形晶格连接、业界领先的每秒最大电路数以及实时脉冲控制能力,使研究人员能够逐脉冲深度控制量子计算机。
将经典硬件放置在量子处理器旁边,核心目的是降低延迟。量子纠错需要在量子测量与后续操作之间保持紧密协调——解码器(识别量子比特错误的经典软件)必须跟上量子处理器的节奏。分散在云端和独立系统的传统工作流,每次交接都会增加复杂性和延迟。
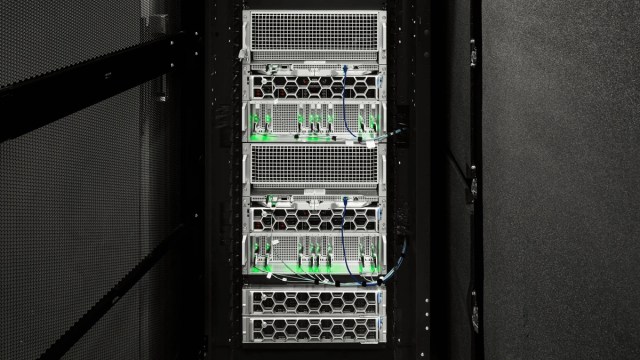
这是橡树岭国家实验室 (ORNL) Umbra 高性能计算系统的特写,该系统由 AMD Instinct MI355X GPU 和第五代 AMD EPYC CPU 组成。Umbra 与 IBM 量子计算机位于同一地点,共同构成量子纠错的协同设计平台。(来源:IBM)
纠错为何是关键:从70个逻辑量子比特到10万次操作
量子比特在计算过程中会产生错误,约每几百次操作出现一次。不加以纠正,错误会迅速累积,使长而复杂的计算无法进行。纠错码将信息分散到多个物理量子比特上,并通过重复测量识别错误。
该平台对接美国能源部量子创世纪任务(Quantum Genesis Mission) 及其Q竞赛目标:到2028年底实现100个逻辑量子比特运行10万次硬操作。IBM目前披露的实验进展为70个逻辑量子比特、438次硬操作,达到2028年目标意味着硬操作数量需提升约230倍。
IBM Research总监Jay Gambetta表示:“问题已不再是纠错能否在量子硬件上工作,而是如何加速和优化纠错,构建科学家可以用来解决有意义问题的系统。”
分工与延伸:量子、HPC与AI的协同设计
三方分工明确:IBM提供量子处理器与脉冲级控制API;ORNL提供科学研究环境与Umbra系统;AMD提供EPYC CPU(系统编排)、Instinct GPU(模拟与并行计算)、Versable自适应SoC(低延迟控制与解码)及ROCm开放软件生态。
该平台还将连接ORNL的领先计算设施(OLCF),后者部署了基于AMD EPYC与Instinct的Lux超级智能(SI)及HPC超级计算机。这意味着研究环境可延伸至完整规模的计算系统,探索量子、AI与科学计算如何协同演进,而非孤立发展。
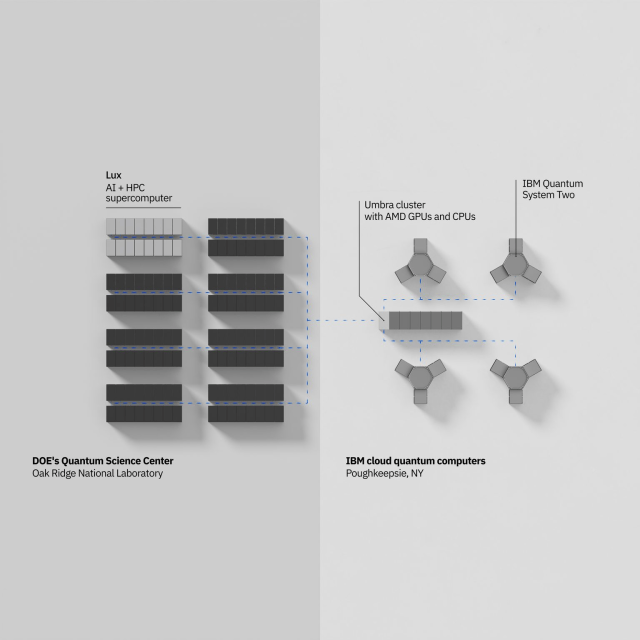
IBM、ORNL 和 AMD 联合开发的新型量子纠错平台示意图(来源:IBM)
定位:研究平台,而非商业产品
IDC分析师Heather West明确指出,这是一个研究平台,而非商业产品。其价值在于让研究人员在真实硬件上测试不同纠错方法,并了解每种方法对量子和经典资源的需求。
IBM量子中心超级计算首席技术官Jerry Chow用一个类比解释量子计算机的角色:CPU擅长算术运算,GPU擅长张量运算,而量子计算机擅长量子电路运算——“当你的问题最适合用量子电路来表示时,就可以交给量子计算机处理。”
平台积累的纠错与HPC工作流经验,预计将为IBM计划于2029年交付的首台容错量子计算机Quantum Starling提供架构与软件层面的参考。
来源:IBM官方博客、SiliconANGLE、PR Newswire、CTIMES报道。
- 收藏
 粤公网安备44030002015498号